Autoencoder
Starryue
•
25 September 2026
•
3 mins
Generative Models
什么是generative model? 输入给定的noise(可以是各种形态,但需要知道其分布)输出data
Autoencoder
def: 前馈神经网络,输入 $x$ 目标:预测/重建/还原 $x$
神经网络可以逼近任意连续函数(通用逼近定理)简单来说,对于一个定义在有限范围内的连续函数,只要神经网络具有合适的非线性激活函数,并且有足够的隐藏单元(足够宽,中间层很高维度),那么理论上总能找到一组网络参数,使网络的输出和目标函数之间的误差小到任意程度。
直观上,如使用 ReLU 激活函数时,每个神经元可以产生一个分段线性的结构。多个神经元组合起来,就可以形成很多段折线,而足够细的折线可以越来越接近一条连续曲线。因此,随着网络表达能力增加,它可以逼近非常复杂的函数。
但是这么一个逼近 $f(x)=x$ 的trivial solution是没有意义的,我们需要让encoded后的东西比原来$x$的信息更加“紧凑、压缩”,所以采用Bottleneck architecture:输入维度较高的 $x$ –> 低纬的表示 –>还原出高纬度的 $x$,前后两部分分别为encoder、decoder
应用:数据压缩,高维数据的二维可视化,unsupervised representation learning(pretraining),生成模型
最简单的autoencoder:
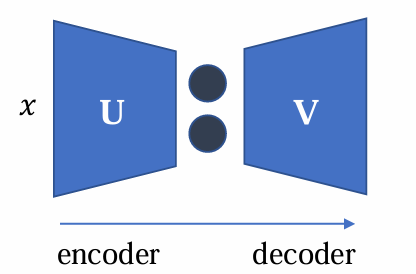
- linear网络
- $k«d$:$若 k=d,可以让VU=I,没有压缩效果即无意义$
- 如何确定$U,V$?$minimize \left| VUx - x \right|_2$ 这是一个Principled component analysis主成分分析,有多个可能解如$U^, V \rightarrow U^\times2, V^/2$
总结:一个autoencoder可以描述成 ==$f(g(x))=x$==,$f,g$函数分别为decoder, encoder,$h=g(x)$ 称为the code/ representation/latent variable of x
- 这里$f$ 和 $g$ 不应太复杂,否则容易直接学会copy和paste从造成过拟合
- 压缩是data-specific的,如用猫相关的图片训练出的
autoencoder,无法很好压缩狗相关的图片 - vanilla
autoencoder不是一个generative model!输入的 $x$ 虽然是一个分布,但不知道该分布具体是什么;但如果经过一系列训练后,可以构建出经过encoder的 $h$ 遵从已知的分布如标准正态分布,此时扔掉encoder将其替换为random noise如 $N(0,I)$,只留decoder ,这就是generative model
如何在训练后让 $h$ 成为 known distribution?
Variational Autoencoder
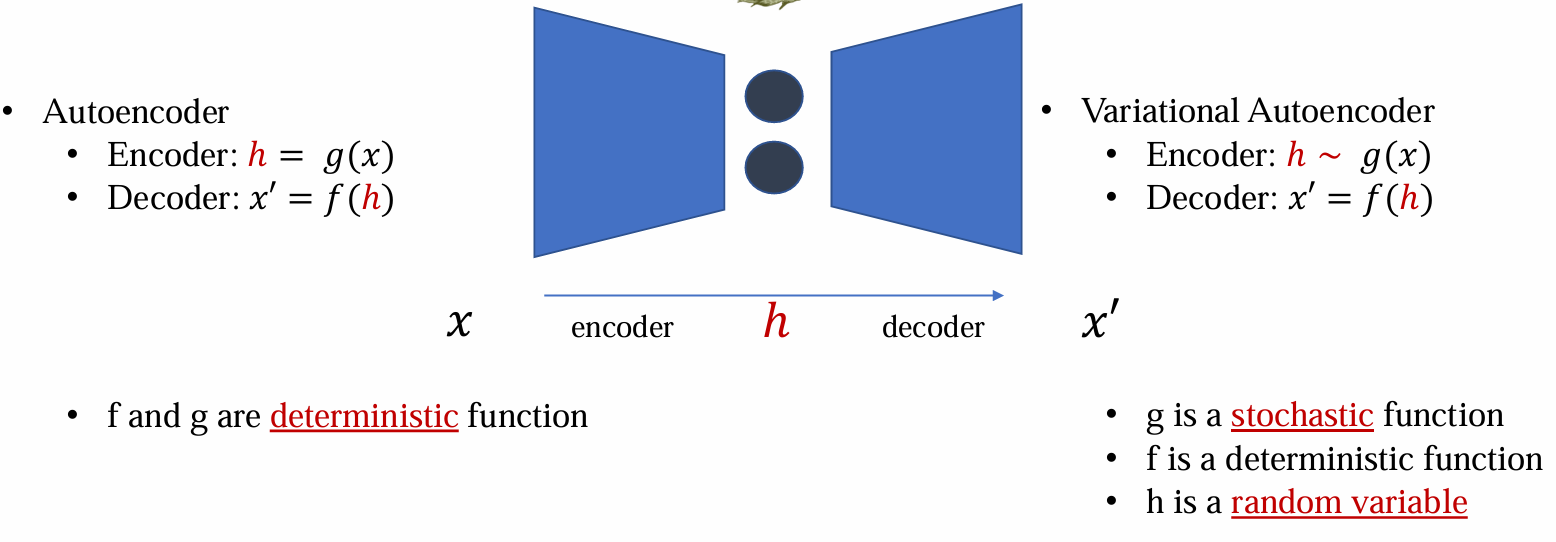
variational autoencoder 和 autoencoder 的区别:对encoder加入一些随机性,目的是把 $h$ 变为distribution
直观理解:把 $h$ 当成一个随机变量,给定 $x$ 后不是通过神经网络计算出 $h$,而是sample采样出 $h$
Known distribution
预先定义一族分布,$g$ 确定性地输出参数(如标准正态分布的均值、方差)后就可以采样 $h$
Training
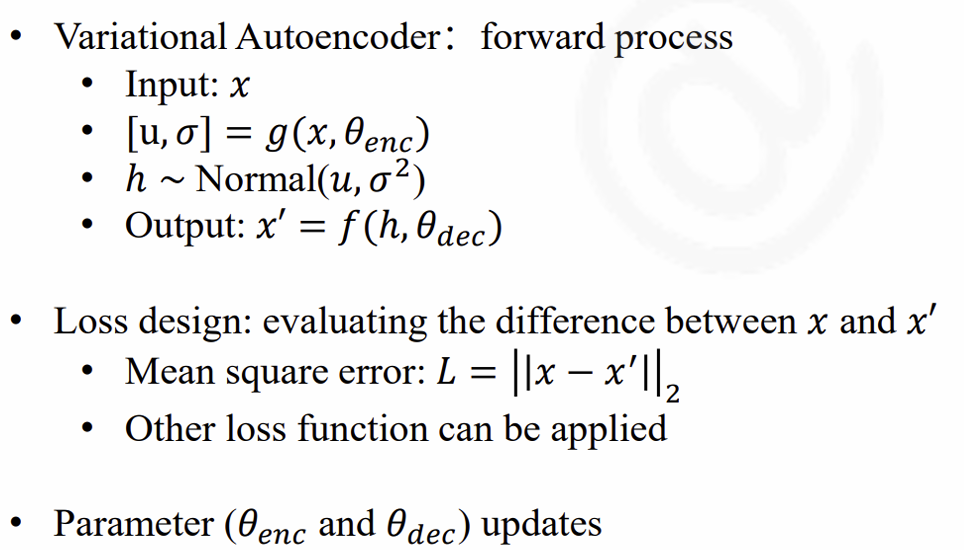
Parameters ($\theta_{enc}, \theta_{dec}$ ) updates
- 参数更新——$\theta_{dec}$:
由链式法则: \(\frac{\partial f}{\partial \theta_{dec} }= \frac{\partial L}{\partial f}\frac{\partial f}{\partial \theta_{dec}}\) 每一步均可导 √
-
参数更新——$\theta_{enc}$: \(L = \left\| x - x' \right\|_2 =\left\| x - f(h,\theta_{dec} ) \right\|_2, h \sim Normal(g(x,\theta_{enc}))\) 计算 $\frac{\partial L}{\partial \theta_{enc}}$: $L$ 对 $h$ 可导,$g$ 对 $\theta_{enc}$ 可导;但是$h$ 对 $g$ 是采样的过程,$g$ is NOT differentiable with respect to $h$! (g不管变动多少,这次sample出h的变化是不可控制的)
因此需要其他方法处理不可导的问题
==Reparameterization 重参数化==
原本流程如下图,但是由于sample的问题导致那一步不可导
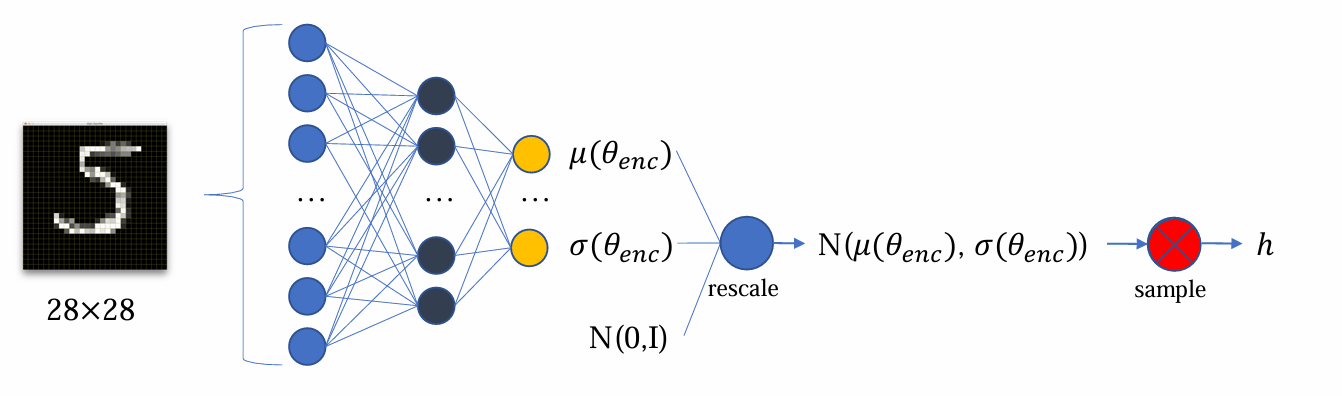
现在提前sample的过程,先采样出一个标准正态分布的noise $\epsilon$ (与数据无关的噪声)
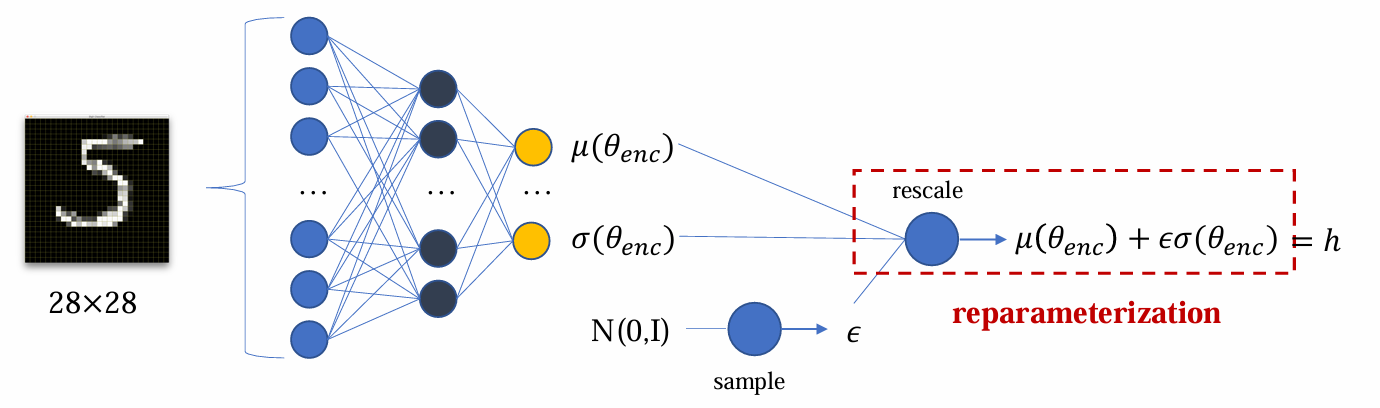
此时反向传播的梯度中,sample涉及的$\epsilon$不在$h$到$\theta_{enc}$的过程中,这样就可导了
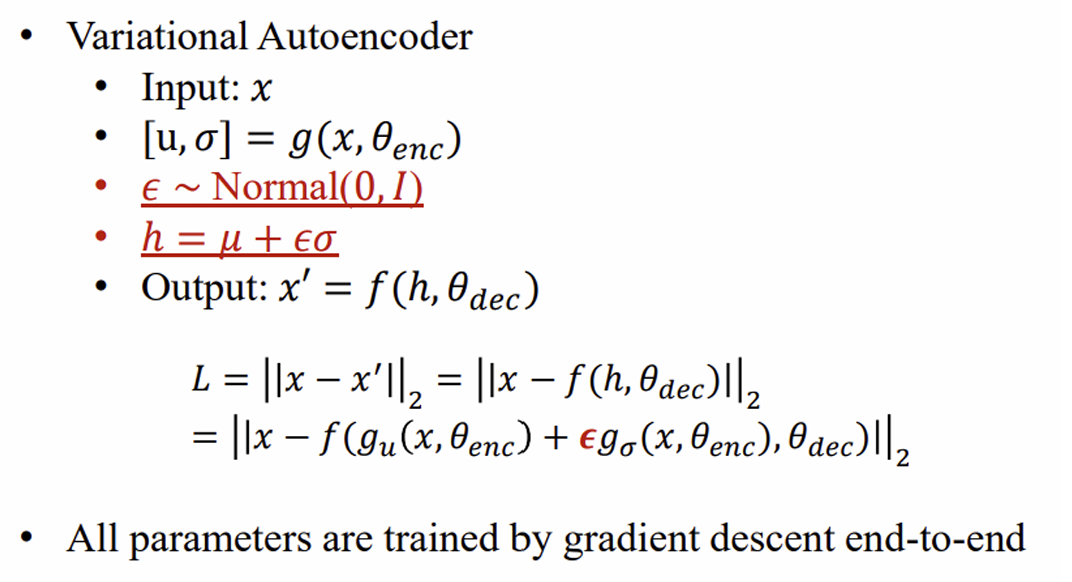
noise选择的分布比较重要,这里先选择高斯分布
Inference
我们希望 $x$ 在VAE训练中得到的 $h$ 是具有随机性的,但又不要那么随机/一定程度上可控,希望不同的$x$ 得到的 $\mu, \sigma$ 即distribution 尽可能贴近(否则每一个 $x$ 都会得到一个distribution,真正推理的时候存在问题:这个noise应该按照哪一个distribution放入encoder)
所以加入约束:不同的 $x$ 得到的distribution 尽可能贴近标准正态分布。整个VAE会有以下损失:
- Recontruction loss: $L=\left| x-x’\right|_2$
-
Regularization loss: $L_r=KL(N(\mu(x),\sigma(x)) N(0,I))$ - Overall loss = $L+ \lambda L_r$
[!NOTE]
$\epsilon \sim Normal(0,I)$ 和 $L_r=KL(N(\mu(x),\sigma(x)) N(0,I))$都引入了标准正态分布,但意义不同: 前者是为了解决梯度无法计算的问题,因而要重参数化一个高斯分布的采样【优化角度】
后者是希望 $\mu, \sigma$ 中间生成的h分布更接近标准正态分布,帮助完成generative model 的作用【生成模型目的】
Probabilistic view
从概率学角度说明VAE设计的合理性
(假设数据$x$是独立同分布的,同时也关心这样的数据是如何产生的–结构性建模)VAE认为数据的⽣成过程有 latent code 即潜表达。无法建模出 x 的分布, 但是我们能够建模出潜表达 z 的分布 (latent code distribution) 称为 prior distribution 先验分布。
| 问题变为一个数据集$D={x_i}$,学习出$p(x | z)$(即在已知潜变量 $z$ 的情况下学习出 $x$ 的分布,也就是decoder的工作流程) |
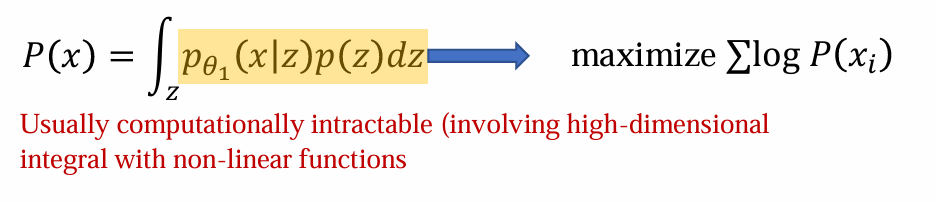
采用极大似然估计:找到一个 $\theta_1$ 使得最大化 $p(x)$的似然 由于 $p(x,z)=p(x|z)p(z), p(x)=\int p(x,z)dz$ ,因此 $p(x)= \int p(x|z)p(z)$,转化为对数形式:
-
我们认为 $p(x z)$ 是好算的,因为这是 VAE 的 decoder 的计算结果,但是不能直接使⽤上面的公式直接求出$P(x)$:$p(z)$ 是⼀个复杂的多维向量,对其全部积分是难以求出的。
关于MLE:知某个随机样本满足某种概率分布但是其中具体的参数不清楚,参数估计就是通过若干次试验,观察其结果,利用结果推出参数的大概值。
转换思路,考虑这个先验假设:给定任意 $z$, 在整个 $X$ 空间上只有很少一部分的 $p(x|z)$ 是非零的,于是整个积分只有很少一部分非零。例如网购时选定⼀个标签,只有一小部分的商品是符合这个标签的;
如果有另一个分布 $q_{\theta_2}(z|x)$ 能够找到上述这个非零的“region”,这个分布称为 variational posterior distribution,其作用是给定一个数据集,找到符合特定标签的样本。此时变为
$$
\begin{aligned}
\log P(x)
&= \int_z q(z|x)\log P(x)dz
&= \int_z q(z|x)\log \frac{p(x,z)}{p(z|x)}dz
&= \int_z q(z|x)\log
\frac{p(x,z)}{q(z|x)}
\frac{q(z|x)}{p(z|x)}dz
&= \int_z q(z|x)\log \frac{p(x,z)}{q(z|x)} dz
-
\int_z q(z|x)\log \frac{q(z|x)}{p(z|x)}dz \end{aligned} $$
-
第二部分为KL divergence,非负
-
第一部分为$\log P(x)$的 evidence lower bound ELBO,也就是:
-
第一部分由概率公式,意义上等于 ==$\mathbb E_{z \sim q(z x)} [\log p(x z)]$== :含义为先通过encoder编码器,采样一个 $z \sim q(z x)$,然后解码器给出这个在这个潜变量下输出 $x$ 的概率的对数,对应重构项 - 第二部分为负kl divergence:在
VAE中⼀般都认为先验 $p(z)$ 是标准正态分布,即将编码器生成的概率拉向标准正态分布,对应latent space约束
最终,概率学角度看,极大似然估计希望最大化 $\log P(x)$ $\rightarrow$ 最大化其ELBO证据下界 $\mathbb{E}{q(z|x)} [\log p(x|z)] - D{KL}(q(z|x)||p(z))$,即 $\text{max} ELBO$
VAE训练角度看,优化器希望最小化损失,而这里恰好有重建损失+正则损失分别对应ELBO中两项的负值,即 $\text{min} ELBO$
Denoising Autoenoder
在输入阶段加入noise: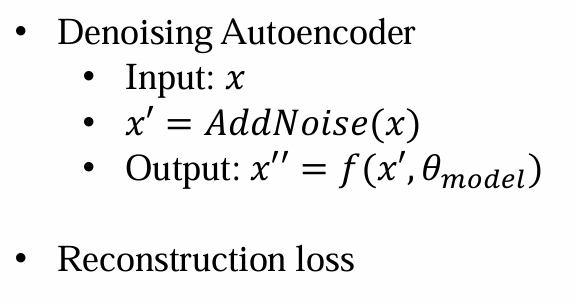
标准的autoencoder存在捷径(idendity mapping,所以做成bottleneck的结构)而对于DAE,神经网络的输入是已经被加噪“破坏“过的图片,希望还原出clean的图片,此时identity mapping还会输出破坏的结果,non-zero loss,并不是平凡解。
所以DAE并不需要botleneck的结构(因而也不会有很明显的encoder/decoder)通常做成很深的结构;
加噪方式——遮挡mask as noise
图片情景:
和VAE用于生成模型不同(扔掉encoder保留decoder处理噪声输入),这里的encoder参数量远远大于decoder,使用时往往扔掉decoder,作为一个理解模型(而非生成模型)
语言情景:类似做”完形填空“
总结
- 有效的pretraining(self-supervised)
- 参数量大、模型深,可以训练出很大的模型
- 任何数据类型都可以按照”遮掩“的逻辑去预测
- 遮掉一部分去预测遗失的部分,但不是通常意义上的generative model,因为DAE总需要给一些signal线索让它预测
Vector quantized-VAE
结构
单独使用的效果有限,通常放在完整的system中,尤其是large-scale vision-language models
类比语言模型的next word prediction,可借鉴其较为成熟的框架做next-token prediction
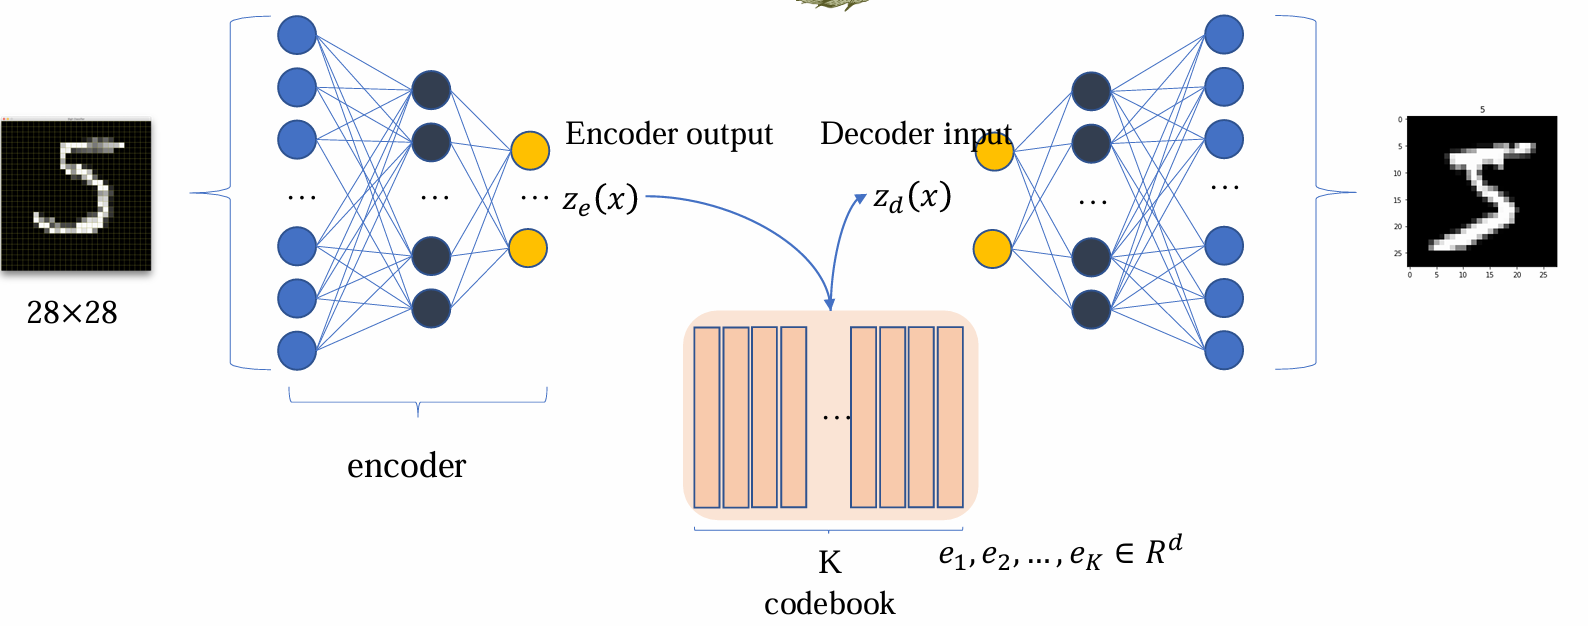
查表:找最近邻(实际情况中,若只找一条,表达能力很有限,通常找一个idx序列)
idx的 $argmin$ 操作(本质是sort)无法计算导数,解决方式: \(z_d=z_e+StopGrad(z_d-z_e)\)
- $StopGrad$ 指这部分的导数不参与计算,不影响forward流程及正确性
- 反向传播过程中,decoder的参数正确
- 反向传播过程中,encoder参数的gradient实际上不是正确的(总会遇到argmin那一步),但是保证encoder的参数是computable,即computable updates
codebook效果
希望codebook是有效的,尽可能避免这种情况:
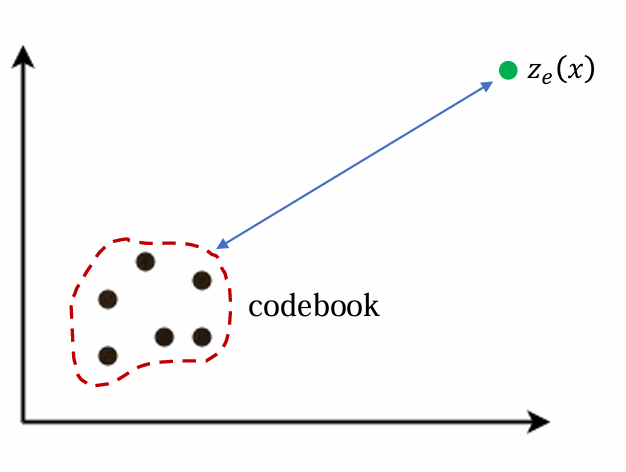
直观上,需要让 codebook 和 $z_e(x)$ 拉近
加入码本损失: \(\left\| z_e-StopGrad(z_d)\right\|+\beta \left\| z_d-StopGrad(z_e) \right\|\) 因此 VQVAE loss = reconstruction loss + codebook loss.
缺点是,由于encoder梯度是incorrect的,训练过程不是很稳定
Like it? Share it!